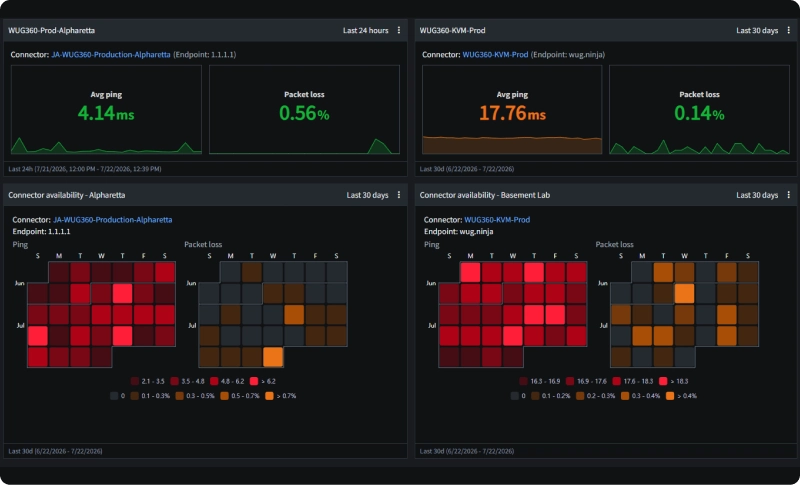
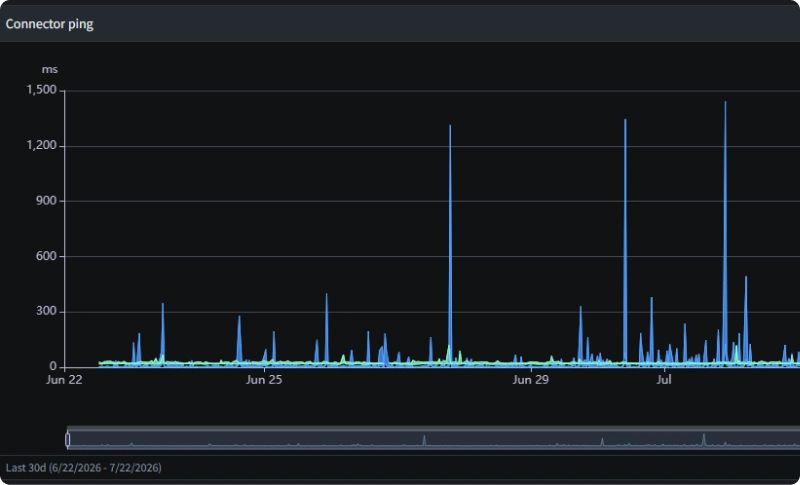
Visualisez les chemins de trafic, détectez les problèmes de latence et de routage, et dépannez les problèmes de performance réseau avant qu'ils ne perturbent les utilisateurs.
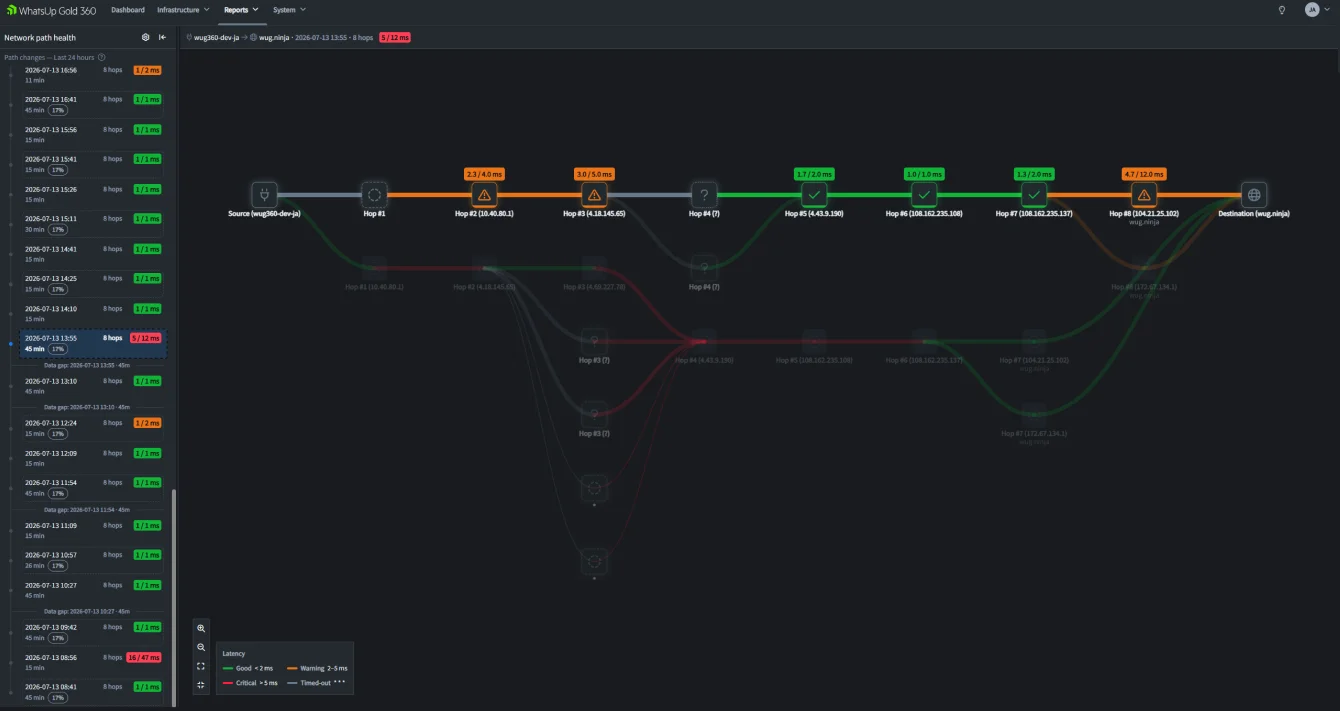
Une application lente ne signifie pas automatiquement que le serveur est lent. Le délai peut provenir d'une liaison WAN de succursale, d'une passerelle VPN surchargée, d'un transfert d'opérateur, d'un itinéraire de transit cloud ou d'un segment contrôlé par le fournisseur que l'équipe réseau interne ne peut pas inspecter directement. Le plus difficile est de séparer ces possibilités tant que l'incident est encore actif.
Le traceroute en ligne de commande reste utile pour une vérification rapide. Il révèle une séquence d'interfaces répondantes en envoyant des sondes avec des valeurs de temps de vie IP croissantes et en enregistrant les réponses ICMP Time Exceeded. Cette sortie est un instantané provenant d'une source à un moment donné. L'outil ne conserve pas les informations de routage historiques, ne peut pas identifier le flapping de route au fil du temps et ne peut pas déterminer si un saut de traceroute qui ne répond pas transmet toujours le trafic de production. Les routeurs limitent ou suppriment fréquemment les réponses de diagnostic, et l'équilibrage de charge peut entraîner des sondes successives à suivre des chemins différents.
La surveillance du chemin réseau comble cette lacune en matière de preuves en effectuant des mesures répétées d'un point d'observation défini vers une destination définie. Le résultat utile n'est pas simplement un traceroute plus joli. Il s'agit d'une série chronologique : quels sauts ont répondu, combien de temps les sondes ont pris, où la perte est apparue pour la première fois, si la destination est restée accessible et ce qui a changé au moment où les utilisateur·rice·s ont remarqué un problème.
Cette distinction est particulièrement importante pour les pannes intermittentes. Un ingénieur du NOC enquêtant à 14:30 peut trouver un chemin sain même si les utilisateurs ont subi un délai important à 13:55. Les données historiques du chemin donnent à l'ingénieur des éléments concrets à comparer : l'itinéraire normal, l'itinéraire de l'incident et le point où les temps de réponse ont changé.
Une vue de chemin réduit la zone de recherche. Lorsque la latence est normale sur le campus et augmente après le transfert au FAI, l'action suivante est différente d'un cas où le délai commence au pare-feu de premier saut. La vue devrait aider un opérateur à identifier le premier changement soutenu, et non pas seulement à mettre en évidence le saut avec le nombre le plus élevé. Une seule réponse ICMP lente peut refléter une limitation de débit du plan de contrôle plutôt qu'un délai de transmission.
Sans données de chemin d'accès stockées, les administrateurs répètent souvent les pings, les traceroutes, les vérifications d'interface et les tests d'application depuis plusieurs emplacements. Les mesures continues préservent l'état qui existait pendant l'incident. Cela réduit le temps passé à essayer de recréer une condition qui a déjà disparu et donne au dossier d'incident une référence technique partagée.
Les routes Internet et WAN changent pour des raisons légitimes, notamment la politique de routage, la maintenance, la récupération après panne, les décisions SD-WAN et l'ingénierie du trafic en amont. Un changement de route n'est pas automatiquement une défaillance. Il devient pertinent lorsqu'il coïncide avec une latence plus élevée, une perte à destination, des transactions échouées ou un changement d'expérience utilisateur. Les opérateurs expérimentés corrèlent l'événement de route avec les symptômes du service avant d'attribuer la cause.
Une capture d'écran montrant la source, la destination, l'heure de l'incident, l'itinéraire et la première dégradation observable est plus utile que « le réseau est lent ». Elle ne prouve pas la propriété à elle seule, surtout sur les réseaux de fournisseurs, mais elle donne à l'ingénieur·e destinataire une fenêtre temporelle et un segment de chemin précis à investiguer.
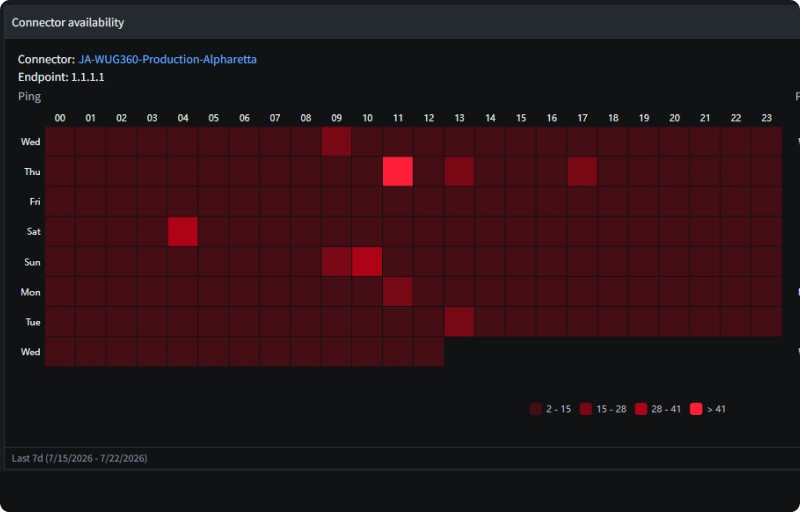
Prenons l'exemple d'une agence où une application ERP ralentit pendant dix minutes chaque après-midi.
L'équipe serveur constate une activité normale du CPU et de la base de données. Le routeur de l'agence ne signale aucune saturation d'interface prolongée. Un traceroute ponctuel effectué ultérieurement indique un chemin normal.
La surveillance historique des chemins modifie l'enquête. La chronologie de l'itinéraire montre que le trafic s'est déplacé vers un chemin de transport secondaire pendant la fenêtre affectée. La réponse des sauts a augmenté immédiatement après la périphérie du transporteur, tandis que la destination a également montré une latence de bout en bout élevée. Ce schéma ne prouve pas que le transporteur a causé le problème, mais il fournit à l'administrateur réseau une escalade ciblée : horodatages exacts, source et destination affectées, changement d'itinéraire et impact mesuré.
Le monitoring du chemin réseau comble ce manque de preuves en effectuant des mesures répétées d'un point d'observation défini vers une destination définie. Le résultat utile n'est pas simplement un traceroute plus joli. Il s'agit d'une série chronologique : quels sauts ont répondu, combien de temps les sondes ont pris, où la perte est apparue pour la première fois, si la destination est restée accessible et ce qui a changé au moment où les utilisateur·rice·s ont remarqué un problème.
Cette distinction est particulièrement importante pour les pannes intermittentes. Un ingénieur du NOC enquêtant à 14:30 peut trouver un chemin sain, même si les utilisateurs ont subi un délai important à 13:55. Les données historiques du chemin donnent à l’ingénieur quelque chose de concret à comparer : l’itinéraire normal, l’itinéraire de l’incident et le point où les temps de réponse ont changé.
Cartographier l’itinéraire observé entre une source de surveillance et une cible telle qu’une application métier, une passerelle de succursale, une charge de travail cloud ou un point de terminaison SaaS. Une carte utile indique l’ordre des sauts, l’adresse ou le nom résolu, l’état de la réponse et le temps de mesure.
Mesurer la réponse au fil du temps à chaque saut visible et à la destination. Les opérateurs*rices doivent rechercher les changements durables qui se poursuivent en aval, comparer avec la même source et la même cible, et tenir compte des différents traitements du trafic de diagnostic.
Enregistrez les changements de chemin observés et conservez suffisamment d'historique pour comparer les périodes normales et les périodes d'incident. Ceci est utile pour les routes instables, les événements de basculement, la connectivité asymétrique et les plaintes qui arrivent après que la route a été rétablie.
Réalisez des mesures à partir d'emplacements qui reflètent le trafic réel : un réseau de siège social, une succursale, un centre de données, un sous-réseau cloud ou un segment d'accès à distance. Une seule sonde centrale ne peut pas représenter toutes les populations d'utilisateurs. Par exemple, un service SaaS peut fonctionner correctement depuis le centre de données tandis que les employé·e·s à distance traversent un FAI, un concentrateur VPN, une réponse DNS ou une périphérie de diffusion de contenu différent·e·s.
Des alertes peuvent être émises sur les conditions sur lesquelles un opérateur peut agir, telles que la perte de destination, une latence de bout en bout soutenue, un renouvellement répété des routes ou un changement de chemin suivi d'une dégradation du service. L'alerte sur chaque saut modifié crée du bruit, car les routes publiques et les chemins à charge équilibrée sont censés varier.
Au lieu de s'appuyer sur des résultats de traceroute isolés ou de comparer manuellement les métriques des appareils, les équipes peuvent visualiser le chemin complet emprunté par le trafic et identifier rapidement l'origine des problèmes de latence, de perte de paquets ou de routage.
Les problèmes réseau ne surviennent pas toujours sous les yeux de quelqu'un. La surveillance continue des chemins d'accès crée un historique des changements de chemin et des tendances de performance, ce qui facilite grandement l'investigation des problèmes intermittents après qu'ils se soient produits.
Le trafic des applications modernes circule entre les succursales, les centres de données, les plateformes cloud, les fournisseurs SaaS et les réseaux FAI. La surveillance de ces chemins de bout en bout permet de déterminer si le problème provient de votre réseau ou au-delà de votre infrastructure.
Plutôt que d'alerter uniquement lorsqu'un appareil se déconnecte, la surveillance de chemin détecte les changements significatifs tels que l'augmentation de la latence des sauts, les changements de route inattendus et la perte de paquets. Cela donne aux administrateur·rice·s un contexte avant que les utilisateur·rice·s ne commencent à signaler des problèmes de performance.
Lorsqu'un problème provient d'un FAI, d'un fournisseur de services cloud ou d'une autre équipe d'infrastructure, les cartes de chemin visuelles et les données de performance historiques fournissent des preuves concrètes de l'origine de la dégradation. Cela réduit les allers-retours lors de la réponse aux incidents et aide la bonne équipe à prendre en charge le problème plus rapidement.
| Capacité | Traceroute de base | Analyse continue du chemin |
|---|---|---|
| Vérification de chemin unique et immédiate | Bonne adéquation | Disponible dans le cadre d'un flux de travail plus large |
| Comparaison historique | Pas d'historique intégré | Enregistre les mesures pour l'examen des incidents |
| Contexte de changement d'itinéraire | Comparaison manuelle | Met en évidence les changements au fil du temps |
| Plusieurs emplacements de surveillance | Exécuter manuellement à chaque source | Utilise des points d'observation déployés, sous réserve de l'architecture du produit |
| Enregistrement d'escalade | Copier la sortie de commande brute | Fournit des preuves visuelles et historiques alignées dans le temps |
| Précision en cas de répartition de charge | Peut afficher des séquences de sauts incohérentes ou trompeuses | Toujours dépendante des sondes ; l'historique répété améliore le contexte mais ne supprime pas les limites de mesure |
Traceroute n'est pas obsolète. Il reste le moyen le plus rapide de poser une question précise à partir d'un shell. La pratique dépassée consiste à considérer une seule trace comme une preuve concluante du chemin d'application, à supposer que chaque saut silencieux est un échec ou à ne conserver aucun historique pour les services intermittents. La surveillance continue est la meilleure option par défaut pour les chemins critiques.
Chaque réseau est différent, mais le processus de dépannage est le même : on commence par surveiller les chemins les plus importants, on établit une base de référence pour des performances normales et on étend la visibilité à mesure que l'environnement se développe. Que le trafic reste au sein d'un même site ou traverse des fournisseurs de cloud, des FAI et des plateformes SaaS, la surveillance continue des chemins fournit le contexte nécessaire pour enquêter sur les problèmes de performance en toute confiance.
WhatsUp Gold est conçu pour s'intégrer aux opérations réseau existantes plutôt que d'imposer un nouveau modèle de surveillance. Que vous gériez une infrastructure sur site, sur plusieurs sites ou dans un environnement hybride, la surveillance des chemins peut être introduite progressivement en se concentrant sur les applications et les services qui présentent le plus grand risque opérationnel.
Plutôt que de surveiller toutes les destinations possibles dès le premier jour, commencez par les services sur lesquels les utilisateurs*rices comptent le plus. Les plateformes d'authentification, les systèmes ERP, les services VoIP, les passerelles VPN, les applications destinées aux client*es et les principales plateformes SaaS sont souvent les premières voies que les administrateurs*trices choisissent de surveiller, car elles ont le plus grand impact lorsque les performances se dégradent.
À mesure que la confiance augmente, la couverture peut être étendue à d'autres succursales, charges de travail cloud, points de terminaison et emplacements distants sans submerger les opérateurs d'alertes inutiles.
Savoir qu'une connexion est lente n'est qu'une partie de l'histoire. Une surveillance efficace du chemin enregistre les informations nécessaires pour expliquer pourquoi les performances ont changé, permettant aux administrateurs de comparer le comportement actuel avec les tendances historiques.
Cela inclut généralement les informations de routage, la latence saut par saut, la perte de paquets, le comportement de réponse, les changements de route et les métriques de performance historiques qui aident à distinguer les problèmes intermittents des pannes persistantes.
La surveillance des chemins réseau devient plus précieuse lorsqu'elle s'intègre aux flux de travail que ton équipe d'exploitation suit déjà. Les alertes doivent alimenter les tableaux de bord existants, les systèmes de billetterie et les processus du NOC afin que les incidents puissent être étudiés sans basculer entre plusieurs outils.
Utilisez une évaluation guidée pour cartographier les routes importantes, placer des points de surveillance là où ils représentent un trafic réel, et tester comment WhatsUp Gold enregistre un changement de chemin ou une dégradation de service dans votre environnement.